Tahle kauza je osm let stará. Vrátil jsem se k ní, když jsem po článku o Strangler Fig hledal pořádně doložený případ velkého třesku v bankovnictví. Existuje a je moc dobře popsaný. Banka si sama nechala udělat nezávislý přezkum, který má 262 stran.
Velký třesk sám o sobě není špatná volba, jenže je to volba a v TSB ji nikdo neudělal. Přišla jako předpoklad, se kterým šel Sabadell do akvizice, představenstvo o ní nikdy pořádně nemluvilo a rizika, která z ní plynou, se nedostala ani do seznamu rizik.
A ještě jedna věc na úvod, protože se to často plete (a mně se to pletlo taky). Migrace dat proběhla podle plánu, nefungovala ale platforma, na kterou ta data přišla.
Proč mě to zaujalo?
Protože tady nemusím nic domýšlet. U většiny fiasek, o kterých jsem tady psal, si obrázek skládám z článků a zpráv, které si navzájem někdy až odporují. Tady si banka najala právní kancelář Slaughter and May, dala jí přístup k zápisům z představenstva, k e-mailům, k exportu z Jiry i k lidem, a report pak celý zveřejnila. Včetně pasáží, které pro ni vyznívají dost špatně.
A hlavně: žádné z rozhodnutí, která k tomu vedla, nevypadá při čtení hloupě. Což je na tom asi to nejhorší.
Co se vlastně stalo?
| Datum | Co se dělo |
|---|---|
| červen 2014 | TSB se odděluje od Lloyds Banking Group. Smluvně může její platformu používat až do července 2024 |
| 1. 7. 2015 | Den po tom, co se nabídka Sabadellu na převzetí stala bezpodmínečnou, existuje datum spuštění: neděle 5. 11. 2017. S koncem roku 2017 Sabadell počítal už při nabídce v březnu, ještě bez detailní znalosti požadavků |
| 15. 3. 2016 | Po devíti měsících plánování uvnitř TSB vychází první plán. Se stejným datem |
| 20. 9. 2017 | Představenstvo uznává, že to nestíhá, a zadává přeplánování |
| 29. 9. 2017 | Devět dní nato, ještě před dokončením přeplánování, TSB veřejně oznamuje: migrace „do Q1 2018“ |
| ~konec února 2018 | Padá rozhodnutí testovat výkon jen na jednom ze dvou datacenter. Mimo governance, v zápisech není |
| 9. 4. 2018 | Vedení formálně podepisuje požadavky na výkon, zátěž a stabilitu. Třináct dní před spuštěním |
| 17. 4. 2018 | Celková připravenost výkonnostních testů se ve zprávě o testování mění ze šedé na zelenou. Na pokyn CIO |
| 22. 4. 2018, 18:00 | Spuštění po migračním víkendu. Za dvacet minut první hlášení, že klienti vidí zůstatky, které nepoznávají |
| 23. 4. 2018 | Sabadell vydává tiskovou zprávu, že migrace proběhla úspěšně |
| 3. 9. 2018 | Generální ředitel Paul Pester odchází z představenstva |
| 19. 11. 2019 | TSB publikuje nezávislý přezkum Slaughter and May |
| 20. 12. 2022 | Regulátoři FCA a PRA pokutují TSB dohromady 48,65 mil. GBP za selhání v řízení provozního rizika a outsourcingu |
| 13. 4. 2023 | PRA pokutuje bývalého CIO částkou 81 620 GBP |
Co vlastně TSB migrovala?
Nešlo o přesun dat na hotovou platformu. Platformu Proteo4UK navrhl, postavil a provozoval SABIS, IT dodavatel ze skupiny Sabadell a sesterská firma TSB. Report rozkládá program na čtyři samostatné části a každá z nich by sama o sobě byla velký projekt:
- Nový software. Aplikace pro jednotlivé kanály (web, mobil, pobočka, telefon) i middleware byly z velké části nové. Tedy ty vrstvy, přes které se klient s bankou baví.
- Nová infrastruktura. Nová datacentra, propojená novou sítí.
- Migrace dat z platformy Lloydsu.
- Samotný přechod.
Platforma se přitom upgradovala z verze Proteo3, která běžela ve Španělsku, na Proteo4 s novými digitálními funkcemi. Čili dvě velké riskantní věci naráz: přizpůsobení britskému trhu a modernizace architektury.
Představenstvo si podle reportu myslelo, že přesouvá banku na ověřenou platformu s úpravami. Ve skutečnosti se stavěla nová, neověřená platforma a podle toho se k programu mělo přistupovat. Pro představu: přes 70 dodavatelů a přes 1 400 lidí. O přechod na novou platformu takového rozsahu se do té doby žádná zavedená britská banka nepokusila.
Kdo rozhodl o velkém třesku?
No, tuhle otázku jsem si při čtení kladl pořád a odpověď je: nikdo konkrétní.
Sabadell měl s migracemi bank na Proteo zkušenost (do té doby jich takhle integroval dvanáct) a jeho plánování ještě před akvizicí počítalo s tím, že se TSB přesune celá přes jeden víkend. Tenhle předpoklad TSB převzala do svého vůbec prvního plánu z března 2016 a nikdo ho už nezpochybnil.
Report přitom velký třesk neodsuzuje:
The advantage of a single event migration is that it is the fastest, cheapest and least complex way to proceed. However, if a bank does opt for a single event migration, it is critical that the risks of this approach are understood and that the platform is robustly tested before it is put live to all customers.
[…] It would not necessarily have been the wrong approach had the right mitigants been put in place.
TSB did not give sufficient consideration as to whether a largely single event migration was the right choice […]. This choice was not substantively discussed by the TSB Board.
Velký třesk si tedy kupujete za cenu toho, že všechno ostatní musí být hotové.
U sebe bych takové rozhodnutí dal do ADR, včetně toho, co za tu rychlost platím, a rizika z něj do registru rizik. TSB je tam nedala a podle reportu tím ztratila přehled, jaká opatření vlastně potřebuje. Riziko, které nikde není napsané, se během projektu prostě vypaří. A platí to i pro předpoklad, který zdědíte: jakmile ho převezmete, je to vaše rozhodnutí a následky ponesete vy.
Odkud se vzal termín?
Posloupnost je v tabulce nahoře a nejspíš ji poznáte i odjinud. Datum spuštění existovalo devět měsíců předtím, než vznikl první plán TSB, a plán se prostě dopočítal zpátky od data. Report tomu říká ambiciózní a nerealistický harmonogram a dodává, že u toho už program zůstal až do konce: nejdřív datum, pak plán, ať je realistický nebo ne.
A když v září 2017 došlo na první odklad, TSB si situaci ještě zhoršila. Představenstvo zadalo přeplánování a devět dní nato, ještě než bylo hotové, banka veřejně oznámila nový termín „do Q1 2018“. Nikdo v tu chvíli nespočítal, kolik práce zbývá. Jako důvod odkladu banka navenek uvedla očekávané zvýšení sazeb Bank of England, ne to, že je program měsíce pozadu. Tím naznačila, že na listopad by platforma hotová byla, a zavřela si dveře k dalšímu odkladu. Ten by totiž znamenal přiznat, že to nebyla pravda.
Report uvádí otázku, kterou představenstvo mělo položit a nepoložilo: proč je rozumné čekat, že banka bude připravená jen o čtyři měsíce později, když jsou některé části programu pozadu až o sedm měsíců.
Proč nestačil postupný přechod?
TSB se snažila riziko migračního víkendu snížit tzv. Transition Events (dílčími předsunutými přechody). Mobilní aplikace v roce 2017, platební schémata, bankomaty a sjednávání hypoték na začátku roku 2018. Vypadá to jako ten postupný přístup, který sám doporučuju.
Jenže podle přezkumu šla takhle do provozu jen malá část platformy, takže riziko migračního víkendu se skoro nezmenšilo, a ověření v ostrém provozu (Live Proving) neproběhlo v dostatečném rozsahu.
A je tam ještě jeden důsledek, který mi přijde důležitější. Program neměl vyhrazené prostředí pro výkonnostní testy (report jim říká non-functional testing a spadá tam výkon, zátěž i stabilita). Předprodukční prostředí, se kterým smlouva s dodavatelem původně počítala, se odsunulo až za spuštění (a podle CIO nebylo dodané ani v únoru 2019), takže se testovalo rovnou v produkci. V produkci ale kvůli Transition Events už běžely živé služby, třeba bankomaty, a ty bylo potřeba chránit. Program si tak sám vyrobil důvod netestovat na produkční topologii. Řešení přitom existovalo: testovat mimo špičku, nebo si to předprodukční prostředí prostě pořídit. Neudělalo se ani jedno.
Proč se netestovalo na tom, co šlo do provozu?
Aby se živé služby nerozbily, padla dvě rozhodnutí:
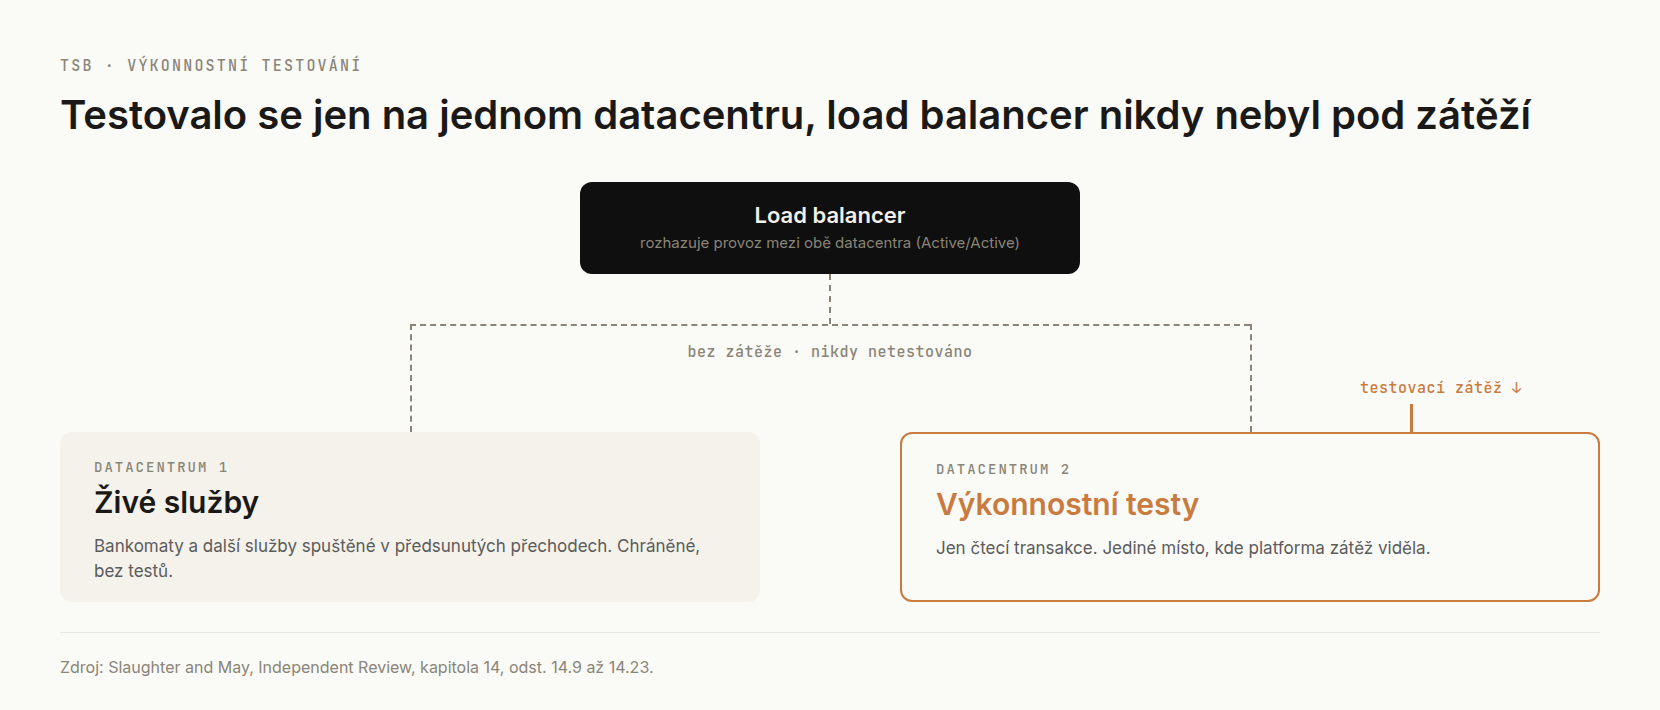
- Testy poběží jen na jednom ze dvou datacenter. Živé služby na druhém.
- V produkci se budou testovat jen čtecí transakce. Nic, co mění data.
Obě jsou docela pochopitelná. Jenže platforma běžela v režimu Active/Active (obě datacentra současně, s load balancerem, který mezi ně rozhazuje provoz). Testováním na jednom datacentru se nikdy neotestovala celá infrastruktura, tedy ani ten load balancer, ani to, jak se aplikace chovají, když běží obě datacentra naráz. A přesně tohle po spuštění nefungovalo. Vlastní analýza TSB označila chování aplikací v Active/Active konfiguraci za „the main contributor to the problems experienced by TSB digital customers“ a banka sama připouští, že při testu přes obě datacentra by problém s timeouty a odpojováním možná odhalila.
Kvůli druhému rozhodnutí zase nikdy neproběhl výkonnostní test plateb na digitálních kanálech. Výkon plateb v mobilní aplikaci pak patřil k hlavním problémům. Na to riziko předem upozornili Deloitte i ředitel řízení rizik banky a podle všeho se s ním před spuštěním nic neudělalo.
K tomu prvnímu rozhodnutí přitom zápis z testovacího fóra z 26. února 2018 říká pravý opak: testovat se má na stávající konfiguraci, aby podmínky odpovídaly tomu, co se čeká při migraci. V praxi se to nestalo. CIO později řekl, že mu dodavatel mimo jednání vysvětlil, proč to jinak nejde. Tahle změna není v žádném zápisu a někteří členové představenstva se o ní dozvěděli až po spuštění. CIO to autorům přezkumu vysvětlil takhle:
This [was] not seen as [a] risk decision at that point in time. I mean, we were taking hundreds of decisions on a weekly basis and it was not the kind of decisions that we were sharing with the board.
A tomuhle já docela rozumím. Rozhodnutí „testujeme na jednom datacentru, ať nerozbijeme bankomaty“ fakt nevypadá jako riziko, které se hlásí nahoru, ale jako běžná provozní domluva. Regulátor to ale později popsal jinak: banka zvážila jen riziko, že testy naruší živé služby. Riziko, že se něco netestuje, vůbec nepojmenovala, a tak se ani nemohla hledat náhradní opatření.
Podobně dopadly soak testy (dlouhé běhy pod zátěží, které mají odhalit, co se rozbije až časem). Pády a zamrzání pobočkového desktopu měl na svědomí memory leak, soak testy ale běžely jen dvě hodiny. Pobočkový systém má vydržet celý pracovní den, takže aspoň tak dlouho měl běžet i test.
Regresní testy byly v plánu jako samostatná fáze a neproběhly. O tomhle se představenstvo na rozdíl od soak testů dozvědělo: na dotaz dostalo od vedení krátký papír, že regresní testy proběhly v rámci jiných fází, tedy generálních zkoušek, akceptačních testů a dalších. Nezeptalo se, jestli to jako náhrada stačí. Chtělo místo toho celkové ujištění, že rozsah testování byl přiměřený.
Zdroj: Slaughter and May, Independent Review, kapitola 14; FCA Final Notice, 2022.
Jak se snížila laťka?
Tahle část mě z celého dokumentu zaujala nejvíc, protože nemá nic společného s technologií.
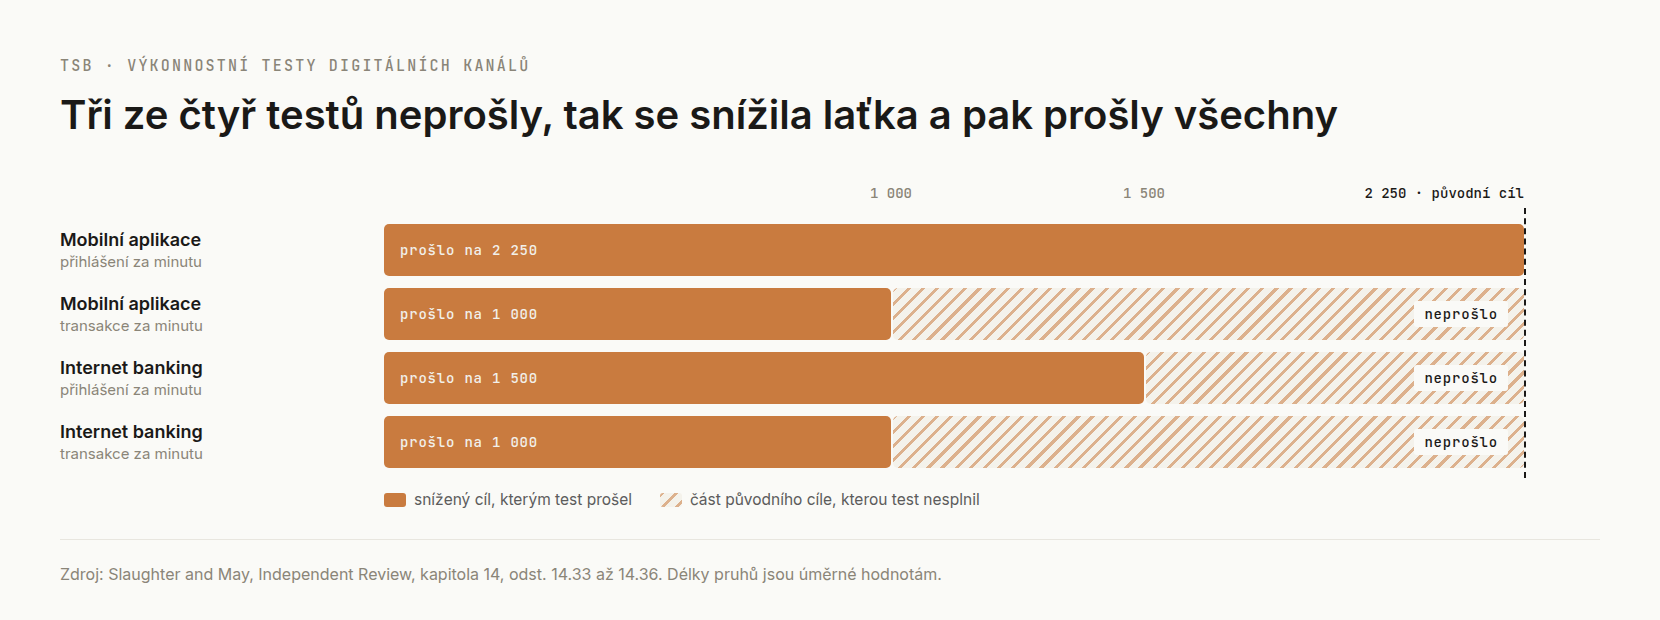
Digitální výkonnostní testy měly čtyři varianty: přihlášení a transakce, obojí zvlášť pro mobilní aplikaci a pro internetové bankovnictví. Cíl byl u všech 2 250 za minutu, což dokumenty popisovaly jako 150 % očekávané špičky přihlášení. Prošlo jen přihlášení v mobilní aplikaci. Tak se cíl snížil na 100 % špičky (1 500 přihlášení a 1 000 transakcí za minutu) a pak prošly všechny.
Zdroj: Slaughter and May, Independent Review, kapitola 14.
Finální zpráva o výkonnostním testování pak uváděla, že digitál je prověřený na 100 % špičky a že 150 % je „pending“. Neuvedla, že testy na 150 % proběhly a neprošly. Vysvětlení, která autoři přezkumu dostali, si navzájem odporovala: že to byla opakovaná chyba, že to byl překlep, že to nebyl cíl, ale mez, při které to má spadnout. Závěr reportu:
In our view, there was a decision to lower the bar for testing in order to pass it […] thereby ignoring, rather than addressing, the issues that may have been causing these tests to fail.
A po spuštění reálný provoz ten snížený cíl překročil. Přihlášení z webu i z mobilu totiž jde přes stejný backend a stejnou infrastrukturu, takže se ta čísla musí sčítat. V prvních třech dnech po spuštění byl součet nad hranicí 1 500 za minutu skoro dvanáct hodin, tedy zhruba šestinu času. Test na souběžné přihlašování přes oba kanály přitom nikdy neproběhl a na tuhle analýzu banka autorům přezkumu neodpověděla.
Kdo přepsal barvičky?
Program používal běžný semafor (RAG statusy). Zelená znamenala „prošlo, žádné významné riziko pro migraci“, oranžová „prošlo s výhradami“, červená „významné riziko“.
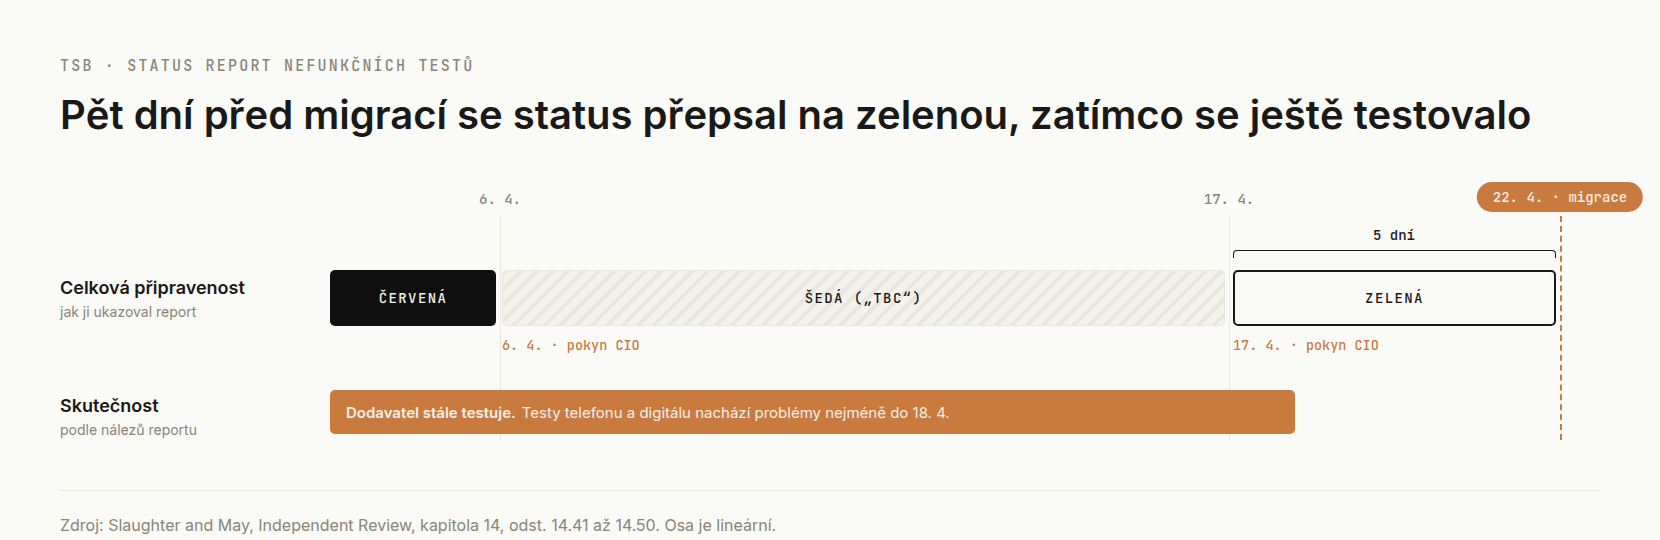
- 6. dubna 2018 byla celková připravenost výkonnostních testů ve zprávě o testování červená. Na pokyn CIO se změnila na šedou („TBC“). Šedá se jinak používala prakticky jen pro „netýká se“. Autoři přezkumu k tomu poznamenávají, že červená 6. dubna znamená, že dva týdny před migrací platforma nebyla schopná projít výkonnostními testy.
- 17. dubna byl telefonní kanál hlášen jako oranžový, kombinovaný test telefonu a digitálu jako červený, protože ještě neproběhl. Po rozeslání zprávy přišel jménem CIO pokyn změnit telefonní kanál na zelenou. A to přesto, že mu vlastní tým e-mailem psal, že dodavatel v téhle oblasti ještě testuje.
- Ten samý den nařídil CIO změnit i celkovou připravenost, ze šedé na zelenou.
- Testování kombinace telefonu a digitálu pokračovalo nejméně do 18. dubna a dál nacházelo problémy s odezvami. Migrovalo se 22. dubna.
Závěr přezkumu je jednoznačný: status byl zkreslen proto, aby finální zpráva o testování mohla podpořit rozhodnutí představenstva migrovat.
Přezkum nikde netvrdí, že chtěl někdo podvádět, a já to netvrdím taky. Podstatné je, že dokument, podle kterého se rozhodovalo, mohl přepsat jeden člověk. A ptám se sám sebe, kdo u mě může přepsat status ve zprávě, podle které se rozhoduje, jestli je hotovo.
Zdroj: Slaughter and May, Independent Review, kapitola 14.
Kolik bylo defektů doopravdy?
Představenstvu se před rozhodnutím reportovalo „kolem 800 defektů“. Podle vlastní pozdější analýzy TSB to bylo nejméně 2 061 defektů z funkčního testování a dalších 1 256 z ostatních forem testování, které řídil dodavatel. Dohromady nejméně 3 317, tedy přes čtyřnásobek.
V hlavním textu materiálu pro představenstvo navíc nebylo nic, z čeho by šlo poznat, že těch zhruba 800 se týká jen funkčního testování. A že to vlastně nejsou defekty, ale položky funkcionality (Items of Functionality), za kterými bylo dohromady 1 270 defektů.
Horší je, že to nikdo nevěděl. TSB v době rozhodnutí ani během přezkumu neměla ucelený pohled na otevřené defekty, protože v Jiře byl nepořádek v kategoriích i prioritách a defekty z testování, které řídil dodavatel, se počítaly zvlášť. Vstupní kritérium pro migraci přitom vyžadovalo, aby nezůstal žádný neošetřený defekt dvou nejvyšších severit. Bez jednoho konsolidovaného seznamu se tohle kritérium nedá vyhodnotit ani teoreticky.
Autoři přezkumu svoji analýzu s analýzou banky nikdy nemohli porovnat, protože TSB odmítla poskytnout podkladová data.
Co se dělo po spuštění?
Banka se chystala na špičku 137 000 transakcí za hodinu v digitálu, necelých 5 000 hovorů za hodinu a 5 500 uživatelů přihlášených naráz v pobočkách. Report k tomu poznamenává, že kdyby digitál vypadl, telefon ani pobočky ten nápor nepoberou. Což se pak stalo.
Neděle 22. dubna, kolem 18:00. Spuštění. Asi ve 18:20 přišla ze sociálních sítí první hlášení, že klienti vidí transakce a zůstatky, které nepoznávají. Šlo o propojené účty a účty, které klienti spravují za někoho jiného a na které normálně přes web ani aplikaci vidět nejde. Zmocněnci navíc viděli účty, ke kterým oprávnění neměli. Kolem 19:00 šly digitální kanály na sedm hodin offline.
Pondělí 23. dubna. Oba digitální kanály od rána vracely chyby a podle CIO byly „unstable and almost unusable“ až do čtvrtka. V aplikaci prošla zhruba polovina pokusů o platbu, na webu ještě míň. Banka počítala s nárůstem hovorů o polovinu a předem se posílila o 255 lidí. Volalo ale přes dvakrát víc lidí než obvykle, čekali průměrně 90 minut a většina to položila dřív, než se dovolala. V pobočkách padal desktop nové platformy dohromady zhruba 4 500× denně a nefungoval chip and pin ani tisk.
A mezitím vydal Sabadell tiskovou zprávu, že platforma je hotová a že bylo úspěšně migrováno přes 5,4 milionu klientů. Mimochodem, odtud pochází číslo, které o kauze koluje. Nezávislý přezkum mluví o „zhruba pěti milionech“ klientů, regulátor o 5,2 milionu. Těch 5,4 milionu je z tiskovky, kterou vlastník banky vydal v den, kdy se lidé do banky nedovolali.
Dál to nebylo o moc lepší. Od 30. dubna začala vlna podvodů a v polovině května byla na zhruba sedmdesátinásobku běžné úrovně. Klientům, kteří odešli k jiné bance, systém přiřadil špatný kód důvodu odchodu a zaevidoval je jako zemřelé. Firmy, kterým platili inkasem, jim pak psaly „To the personal representative of the deceased“. A tři měsíce po spuštění hlásily pobočky pořád cca 300 pádů, 1 400 zamrznutí a 2 000 automatických restartů denně.
A kolik z toho šlo najít předem? Podle vlastní analýzy TSB by širší výkonnostní testy odhalily až 17 z 38 incidentů výkonu a stability. A u funkčních problémů, kde byly hlavní příčinou chyby v kódu, šlo podle reportu zhruba 60 % dopadu chytit v integračních nebo jednotkových testech.
Kolik to stálo?
Podle výroční zprávy TSB za rok 2018 stál výpadek po migraci 330,2 milionu liber:
- odškodnění klientů a související náklady 107,3 mil.
- další lidé a poradci 122,4 mil.
- podvody a provozní ztráty 49,1 mil.
- náprava a související náklady 17,9 mil.
- odpuštěné poplatky a úroky 33,5 mil.
Banka za rok 2018 vykázala ztrátu 101 milionů liber před zdaněním, proti zisku 159 milionů o rok dřív. Se Sabadellem se předběžně dohodla, že podle smluv o dodávce a provozu dostane zpět 153 milionů.
Bacha na dvě věci. V těch 330 milionech nejsou náklady na samotný program. Jen za rok 2018 to bylo dalších 417 milionů. A nejsou v tom ani pokuty (dohromady skoro 49 milionů), které přišly až o čtyři roky později.
K tomu přes 225 tisíc stížností za první rok, zhruba od čtyř procent klientů. A ve druhém, třetím i čtvrtém čtvrtletí 2018 měla TSB největší čistý odliv klientů ze všech bank v britském systému pro přenos účtů (podle dat, ze kterých přezkum vychází). Ve druhém čtvrtletí 2017 byla ještě v plusu o 20 tisíc.
Pokuta pro bývalého CIO z dubna 2023 je pak podle mě na celém případu TSB to nejzajímavější. Dostal ji za to, že dal představenstvu ujištění o připravenosti dodavatele, aniž se přesvědčil, že pro to banka má doklady. Nevzpomínám si na jiný případ, kdy by regulátor vedle firmy pokutoval jmenovitě i IT manažera, a to za nepodložené ujištění.
Co si z toho beru?
Čtyři věci, které vidím i u sebe, jen o pár řádů menší.
1. Prostředí, na kterém netestuju, je taky rozhodnutí. To jedno datacentrum bylo ve skutečnosti rozhodnutí, že se celá třída chyb hledat nebude. Já to dělám v menším pořád (a vždycky mám dobrý důvod): staging bez replikace, jedna instance místo dvou za balancerem, cache vypnutá, protože „by to zkreslovalo“. Od tohohle případu se ptám, co všechno tím zjednodušením přestávám vidět. A jestli je to někde napsané.
2. Odložený test patří do stejné evidence jako odložená funkce. Škrtnutá funkcionalita je vidět, škrtnutý test se ale objeví nejvýš jako věta, že je to pokryté jinde. Tak to v TSB dopadlo s regresními testy. U zkrácených soak testů jsem nenašel ani to. A „pokryto jinde“ je odpověď, u které se má doptat, kde přesně.
3. Zelená v reportu je něčí názor. V TSB šla barvička přepsat jedním pokynem a vedle sebe klidně stál status „připraveno“ a e-mail vlastního týmu, že se ještě testuje. Pokud rozhodnutí visí na jednom souhrnném ukazateli, mělo by být dohledatelné, kdo ho nastavil, kdy a podle čeho. U mě to zní nudně: stačí historie commitů u toho dokumentu.
4. Blízký dodavatel se hůř kontroluje. TSB si u SABIS pořádně neprověřila, jestli platformu umí dodat a provozovat, moc nevyužívala smluvní právo na audit a místo doloženého potvrzení dostala před spuštěním dopis. CIO banky (formálně zákazník) navíc předtím dodavatele fakticky řídil, takže nebylo úplně jasné, kdo nese riziko. Zpráva Deloitte Spain, kterou si objednal sám SABIS a která u něj našla nedostatky v interních kontrolách, se k bance vůbec nedostala. Tohle znám v menším od spřátelených dodavatelů a od kolegů, se kterými dělám roky. Věci se domluví po telefonu, doklad nikdo nechce, protože „to je přece Honza“. Funguje to skvěle, dokud někdo nepotřebuje vědět, co přesně bylo otestované.
Co z toho plyne?
Že velký třesk si můžete dovolit jen tehdy, když jste ochotní ho odložit, jakmile se ukáže, že to nestíháte. TSB tuhle možnost ztratila 29. září 2017, když veřejně oznámila nový termín. Zbylých sedm měsíců se pak dohánělo tím, že se škrtal rozsah, snižovaly cíle a přepisovaly statusy. Což je celkem věrný popis toho, co se stane, když termín nejde posunout.
Zdroje
- Slaughter and May – Report resulting from its Independent Review of TSB’s 2018 migration to a new IT platform, 19. 11. 2019, 262 stran. Zdroj všech citací a čísel v tomhle článku: časová osa kapitoly 3, 4, 6 a 12; testování, laťka a barvičky kapitola 14, odstavce 14.9 až 14.50; defekty kapitola 17, odstavce 17.17 až 17.26; odliv klientů kapitola 19 – https://www.tsb.co.uk/content/dam/tsb-public/documents/media-centre/Slaughter-and-May-final-report.pdf
- TSB Bank plc – tisková zpráva TSB Board publishes independent review of 2018 IT Migration, 19. 11. 2019 – https://www.tsb.co.uk/news-releases/slaughter-and-may.html
- Financial Conduct Authority – Final Notice: TSB Bank plc, 20. 12. 2022, 115 stran. Počty stížností a hodnocení rozhodnutí o testování mimo governance, odstavce 2.14, 4.143 až 4.145 a 4.173 – https://www.fca.org.uk/publication/final-notices/tsb-bank-plc-2022.pdf
- FCA – tisková zpráva TSB fined £48.65m for operational resilience failings, 20. 12. 2022 – https://www.fca.org.uk/news/press-releases/tsb-fined-48m-operational-resilience-failings
- Bank of England / PRA – PRA fines the former Chief Information Officer of TSB Bank plc for a breach of the PRA’s Senior Manager Conduct Rules, 13. 4. 2023 – https://www.bankofengland.co.uk/news/2023/april/pra-fines-former-cio-of-tsb-bank-plc-for-breach-of-pra-senior-manager-conduct-rules
- Banco Sabadell – tisková zpráva k dokončení migrace, 23. 4. 2018, reprodukovaná v článku UK ‚meltdown‘ bank TSB’s owner: Our IT migration was a ‚success‘ (The Register, 24. 4. 2018) – jediný zdroj čísla 5,4 milionu klientů, v článku uvedeno jako tvrzení vlastníka banky – https://www.theregister.com/2018/04/24/tsb_owner_declares_it_migration_demonstrates_capacity_of_technological_management/
- TSB Bank plc – Annual Report and Accounts 2018 (náklady výpadku 330,2 mil. GBP a jejich rozpis, hospodářský výsledek, odchod generálního ředitele) – https://www.tsb.co.uk/content/dam/tsb-public/documents/investors/financial-results-and-reports/2018/tsb-bank-ara-2018.pdf