Tuhle větu znám: „zapneme Redis, bude to rychlejší“. Stránky se načítají pomalu, uživatelé si stěžují a Redis je většinou to první, co v technické diskuzi padne. Naposledy jsem ji slyšel u velkého multisite webu. Redis se zapnul a pomalé to bylo dál.
Problém byl totiž někde jinde. Statické assety (obrázky, CSS, JS, fonty) odcházely se špatnou cache hlavičkou, takže si je prohlížeč pořád dokola ověřoval na serveru (a když jdou přes PHP, stahuje si je pokaždé celé znovu). Redis s tím nic neudělá, protože úzké místo je ještě před aplikací.
Zapnula se prostě ta vrstva, se kterou je nejvíc práce (nový server, knihovna v aplikaci, invalidace v kódu), a přitom stačilo doplnit hlavičky. Ty stojí zlomek té práce a s CDN před aplikací pak cachovaný obsah chodí za jednotky až desítky milisekund. Jenže o CDN nepadne ani slovo, protože zní složitě, zatímco Redis zná každý.
Jak do sebe vrstvy zapadají?
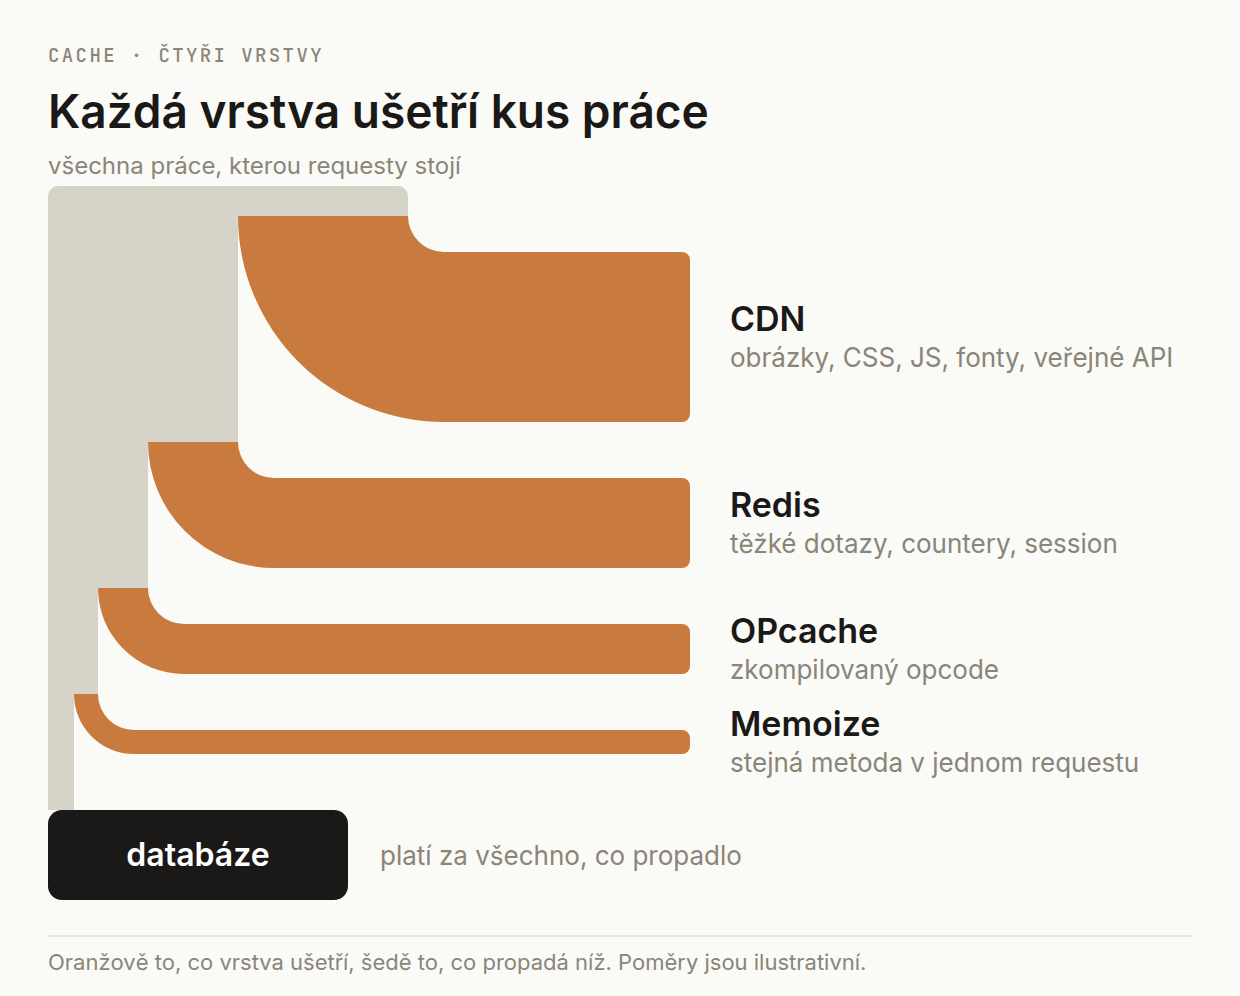
Vrstvy fungují jako takový trychtýř. Je to model, který mi na cache sedí nejlíp: každá ušetří kus práce a to co propadne až dolů, to zatěžuje databázi. CDN část requestů k vašemu serveru vůbec nepustí a Redis zase část dotazů nepustí do databáze. OPcache a memoize nic nezastaví, jen každý request zrychlí. Patří ale až pod CDN a Redis, protože mají užší dosah: OPcache platí pro jeden server, memoize pro jeden request. Hlavní vrstvy jsou tyhle čtyři. Každá má přitom vlastní pravidla invalidace a s tím bývá mnohem víc práce se samotným nasazením.
Co odchytí CDN?
CDN je první vrstva a je nejblíž uživateli. Request se k serveru vůbec nedostane, odpoví za něj CDN z paměti.
Statické assety sem patří vždycky. CDN ale umí cachovat i HTML a API odpovědi (ideálně ty, co jsou veřejné a nemění se každou minutu). Stačí správně nastavené hlavičky Cache-Control.
Invaliduje se buď cache-bustingem, kdy soubor style.abc123.css dostane nové jméno, jakmile se změní obsah, a prohlížeč i CDN tak poznají nový soubor, zatímco zbytek assetů zůstane v cache. Nebo přes purge API, kterým u poskytovatelů (například Cloudflare) ručně shodíte konkrétní URL z cache. To se hodí u stránek a dat, kde se adresa nemění, ale obsah ano.
Špatné hlavičky vám tuhle vrstvu vypnou celou (zapomenuté většinou ne, Cloudflare cachuje statické přípony s vlastním výchozím TTL, jen ho nemáte pod kontrolou). Bacha na jednu záměnu: Cache-Control: no-cache neznamená, že se odpověď neuloží, ale že se před každým použitím musí ověřit na originu. Aby se neuložila vůbec, potřebujete no-store. Jiné TTL pro CDN než pro prohlížeč nastavíte přes s-maxage. A stale-while-revalidate dovolí po vypršení TTL ještě chvíli servírovat starou odpověď, zatímco se na pozadí načítá nová. Hlavičky si projděte pro každý typ obsahu zvlášť, protože pro assety, HTML a API se hodí pokaždé něco jiného.
Na co je Redis?
Redis je cache sdílená všemi instancemi aplikace: všechny workery a všechny servery čtou z jednoho místa. Patří sem výsledky těžkých databázových dotazů a agregací, čítače pro rate limiting nebo dočasný stavy. Vyplatí se, když stejný výsledek potřebujete opakovaně a jeho výpočet trvá víc než pár milisekund. Na stejném stroji se to pohybuje v desetinách milisekundy, po síti kolem milisekundy. U velkých hodnot se k tomu ale přičte serializace na straně PHP a cachovat pole o deseti tisících prvcích pak nemusí být výhra.
Nejjednodušší invalidace je TTL: záznamu nastavíte životnost a Redis ho sám zahodí. Stačí to všude, kde nevadí, že je hodnota chvíli stará.
U dat, kde stará hodnota vadí, zbývá mazání při zápisu: klíč smažete, jakmile změníte data v databázi. Dá to víc práce, ale nikdy nečtete nic starého. Otázka je, kdo za ten klíč odpovídá. Když invalidaci rozházíte po kontrolerech, budete ji dohledávat klidně půl dne. Patří na jedno místo: do handleru, který data mění, nebo do listeneru nad doménovou událostí. Cache je pak jenom další projekce, která se po zápisu znovu postaví.
A pak jsou tu ještě tagy. TagAwareAdapter dovolí každý záznam označit přes $item->tag() a jedním invalidateTags() pak zahodíte všechny klíče kolem jednoho agregátu. Ušetří vám to ruční seznam klíčů, které se musí smazat najednou, a ten seznam málokdy bývá úplný.
Data, která má jen Redis
Redis je in-memory store a při restartu o data přijdete, pokud nemáte zapnutou persistenci (RDB nebo AOF). U dotazů a agregací to nevadí, ty poskládáte znovu z databáze.
Zdroj pravdy má být databáze a Redis nad ní jenom optimalizace čtení. Držet cokoli dalšího jen v Redisu je celkem drahý problém, protože se projeví až při výpadku, kdy na to nikdo nemá čas.
Co se stane, až vyprší horký klíč?
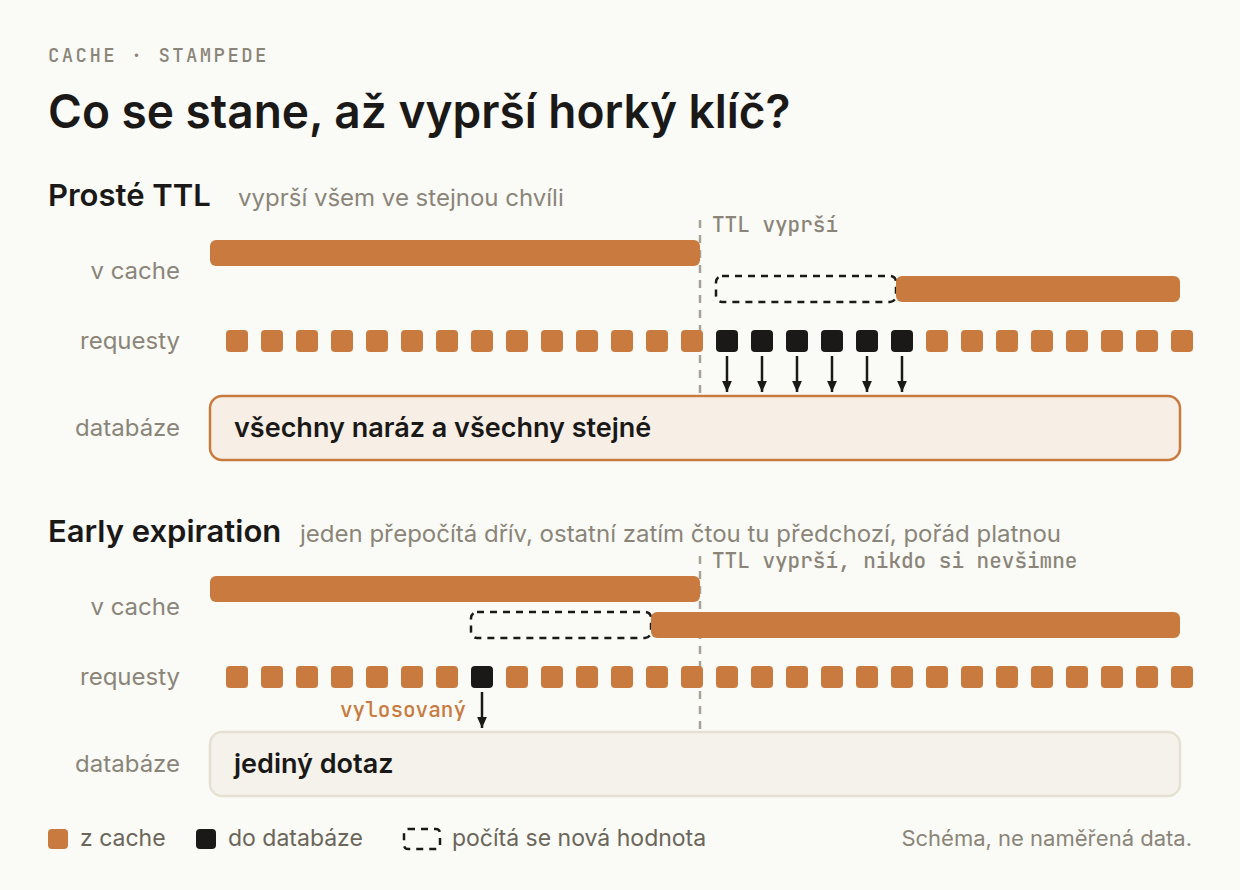
Vezměte si klíč, který čte každý request a jehož výpočet trvá dvě sekundy. Jakmile TTL vyprší, všechny souběžné requesty najdou prázdno a naráz se pustí do stejného těžkého dotazu. Databáze dostane klidně stovku identických dotazů místo jednoho. Říká se tomu cache stampede a zákeřné je na tom to, že bez zátěže ho nepoznáte.
Symfony má proti tomu v Cache Contracts dvě ochrany a obě jsou zapnuté defaultně. Zámek pustí k výpočtu jednoho klíče jen jeden proces a ostatní počkají na výsledek. Drží ale jen v rámci jednoho stroje, na deseti serverech tak dostane databáze deset dotazů místo sta, což je lepší, ale vyřešené to není. Ta druhá ochrana je probabilistic early expiration: některé položky se vyberou k přepočítání, ještě dokud jsou platné. Jeden request si hodnotu spočítá o kus dřív a ostatní zatím dostávají tu předchozí, pořád platnou. Je to podobný nápad jako stale-while-revalidate u CDN, jen obráceně: CDN servíruje starou hodnotu až po vypršení, tady se nová počítá ještě před ním. Řídí to parametr $beta v CacheInterface::get(), kde nula ochranu vypne, INF vynutí okamžité přepočítání a výchozí hodnota je 1.0.
Early expiration ale funguje jen u klíče, který už byl jednou spočítaný. U studeného klíče po deployi, po FLUSHALL nebo po restartu Redisu zbývá jenom ten zámek, a i ten pustí do databáze jeden dotaz z každého stroje. Proti tomu pomůže leda předehřátí v deploy skriptu.
Na ten zámek bych se ale nespoléhal naslepo. Stojí na flock nad pevným seznamem cca 25 souborů uvnitř vendor/symfony/cache/, do kterých se klíč mapuje hashem. Dva nesouvisející horké klíče tak můžou padnout na stejný soubor a čekat na sebe. A když souborový systém flock neumí (třeba některé síťové disky), zámek se tiše přeskočí, callback se spustí bez ochrany a dozvíte se to jen z logu na úrovni info. Na Windows je zamykání vypnuté celé.
use Symfony\Contracts\Cache\ItemInterface;

// $cache je Symfony\Contracts\Cache\CacheInterface, $this->reportBuilder
// je služba z konstruktoru. PSR-6 pool metodu get() s callbackem nemá,
// takže si nechte autowirovat tuhle variantu.
// Callback se zavolá jen při miss a díky zámku a early expiration ho pod
// zátěží spustí jeden request na stroj, ne sto najednou.
$report = $cache->get('report.monthly', function (ItemInterface $item) {
    $item->expiresAfter(3600);
    return $this->reportBuilder->build();
});
Pokud je ten přepočet fakt náročný, dá se při early expiration odsunout na pozadí přes Messenger: volání get() vrátí starou hodnotu okamžitě a novou spočítá worker. Callback ale musí být metoda služby, ne closure, protože se posílá ve zprávě (a ta se serializuje). A týká se to (logicky) jen přepočtu před vypršením, studený klíč se pořád počítá v requestu.
Proč musí být OPcache zapnutý vždycky?
Protože PHP bez něj parsuje a kompiluje každý .php soubor při každém requestu. U pár souborů jsou to jednotky milisekund, u frameworku, který jich načte stovky až tisíce, už je to opravdu hodně znát. OPcache uloží zkompilovaný opcode do sdílené paměti a každý další request si ho přečte rovnou odtamtud.
Direktiv je tu víc, ale záleží vlastně jen na jedné. Ve výchozím nastavení má OPcache validate_timestamps=1 a kouká se na mtime souborů (jak často, to určuje revalidate_freq, výchozí jsou dvě sekundy). Do produkce se doporučuje validate_timestamps=0, protože ta kontrola souborů na disku něco stojí a u tisíců souborů se to nasčítá. Pak už se ale OPcache sám neaktualizuje nikdy a resetovat ho musíte při každém deployi ručně. No, a když si nastavíte nulu a na reset zapomenete, nasadíte novou verzi a poběží vám dál ta stará.
Pozor ale i na to, jak ten reset voláte. opcache_reset() spuštěné z CLI se PHP-FPM vůbec netýká, protože FPM má vlastní sdílenou paměť. Bez opcache.enable_cli=1 navíc neudělá vůbec nic, jen vrátí false a deploy skript vesele pokračuje dál. Nejjednodušší mi přijde reload FPM (kill -USR2 na master proces), jde to ale i chráněným endpointem, který po deployi zavoláte přes HTTP, nebo cachetoolem. Pokud deployujete přepnutím symlinku, pohlídejte si k tomu ještě realpath cache. PHP si skutečnou cestu za symlinkem pamatuje dvě minuty (realpath_cache_ttl) a může tak ještě chvíli sahat do starého release. U nginxu to řeší $realpath_root v SCRIPT_FILENAME.
V Dockeru se OPcache nezapne sám. Oficiální PHP image ho má zkompilovaný, ale nezapnutý, takže si v php -m ověřte, že tam Zend OPcache je, a pokud ne, přidejte do Dockerfile RUN docker-php-ext-enable opcache. Do php.ini pak tohle:
opcache.enable=1
opcache.memory_consumption=256
opcache.interned_strings_buffer=32
opcache.max_accelerated_files=20000   ; zaokrouhlí se nahoru na 32531
opcache.validate_timestamps=0         ; v produkci; reset patří do deploy skriptu
Výchozích 8 MB u interned_strings_buffer je na Symfony málo. Když se buffer naplní, PHP přestane internovat nové řetězce. Nic se nerozbije, jen je to od té chvíle o něco pomalejší a žere víc paměti. Existuje ještě preload, který dokáže třídy nahrát do paměti při startu FPM, vyhraďte si na něj ale celé odpoledne: preloadnuté soubory vymění jen restart FPM (reset nestačí) a u deploye přes symlink zůstanou z toho release, který byl aktuální při startu.
Memoize v jednom requestu
Nejnižší vrstva cache žije jen jeden request, zato nestojí vůbec nic. Výsledek dotazu nebo výpočtu si uložíte do property objektu a při dalším volání v tom samém requestu ho vrátíte místo toho, abyste počítali znovu. Žádný round-trip nikam, jen sáhnutí do paměti procesu. Tu property ale nezapomeňte deklarovat, protože od PHP 8.2 je vytvoření dynamické property deprecated.
Na konci requestu to zmizí samo, takže i invalidace je zadarmo. Což je ale taky hlavní omezení téhle vrstvy: mezi requesty ani mezi procesy nepřežije. Vyplatí se tam, kde stejnou metodu voláte v jednom requestu víckrát, a v aplikaci s event listenery, middlewarem a vnořenými službami takových volání přibývá rychle.
Jenže právě ta invalidace zadarmo přestává platit ve worker módu. Sám ho v produkci nepoužívám, ale ve FrankenPHP nebo RoadRunneru služba mezi requesty žije dál a memoizovaná hodnota jednoho uživatele se klidně vrátí dalšímu, což už je únik dat. Symfony na to má ResetInterface: autoconfiguration takovou službu otaguje kernel.reset a runtime ji mezi requesty resetuje. Tělo reset() si ale musíte napsat sami, nikdo za vás tu property nevynuluje.
use Symfony\Contracts\Service\ResetInterface;

class SubscriptionProvider implements ResetInterface
{
    private ?array $cachedSubscriptions = null;

    public function getSubscriptions(): array
    {
        // ??= spustí dotaz jen při prvním volání v requestu.
        // Prázdné pole není null, takže se dotaz nespustí podruhé
        // ani při prázdném výsledku.
        return $this->cachedSubscriptions ??= $this->db->query(
            'SELECT * FROM subscriptions WHERE user_id = ?',
            $this->userId
        );
    }

    public function reset(): void
    {
        $this->cachedSubscriptions = null;
    }
}
Kdy kterou vrstvu použít?
| Případ | Vrstva | Proč |
|---|---|---|
| Obrázek, CSS, JS, font | CDN | Veřejné, nemění se, latence v jednotkách ms |
| Veřejná API odpověď (produkty, ceník) | CDN + Cache-Control |
Sdílená pro všechny, TTL v hodinách |
| Těžký DB dotaz, mění se zřídka | Redis, TTL v hodinách | Sdílená cache pro všechny instance |
| Data konkrétního uživatele (košík, nastavení) | Redis, klíč per uživatel | Izolace, do CDN nesmí, zdroj pravdy zůstává v databázi |
| Všechno kolem jedné entity naráz | Redis + tag na agregát | Jedna invalidace místo seznamu klíčů |
| Konfigurace a číselníky na jednom stroji | APCu | Bez sítě, ale kopie na každém serveru |
| Stejná metoda volaná 5× v requestu | In-process memoize | Žádný round-trip, žije jen jeden request |
| PHP soubory | OPcache | Zapnutý vždycky, reset patří do deploye |
Jak ale poznáte, jestli vám ta která cache vůbec něco přináší? Bez hit rate nijak a celá tahle tabulka je pak jen dohad. Já si ho hlídám u Redisu přes INFO stats (keyspace_hits a keyspace_misses), u OPcache přes opcache_get_status() a u Cloudflare v přehledu. Po jednotlivých klíčích si ho ale musíte měřit sami. Klíč bez jediného hitu je jen kód navíc. Což platí i pro klíč, který se invaliduje častěji, než se čte.
Čím tedy začít?
Začal bych odshora, u hlaviček a CDN, protože tam toho ušetříte nejvíc a stojí to většinou pár řádků konfigurace. U každé další vrstvy se pak ptám, kolik práce ušetří a co bude stát její invalidace, a teprve podle toho ji zapínám.